X の口コミを自動で収集する方法 2026:毎日 CSV に追記
X(旧 Twitter)の口コミやポストを、社名や商品名、アカウントで毎日自動収集して CSV に貯める 3 つの方法。ポメラ 1 週間分の実測で、件数と重複、費用まで示します。
Weir Team
公開 · 更新 · 約 7 分で読めます
X(旧 Twitter)のポスト(ツイート)を自動で収集するには、検索文を 1 つ決め、毎日その新着だけを CSV に追記します。
自社名や商品名の口コミを、手でコピーしている人向けです。3 つの方法を、キングジムの「ポメラ」で 1 週間試した結果と一緒にまとめました。
検索に使う Weir は、私たちが運営しています。
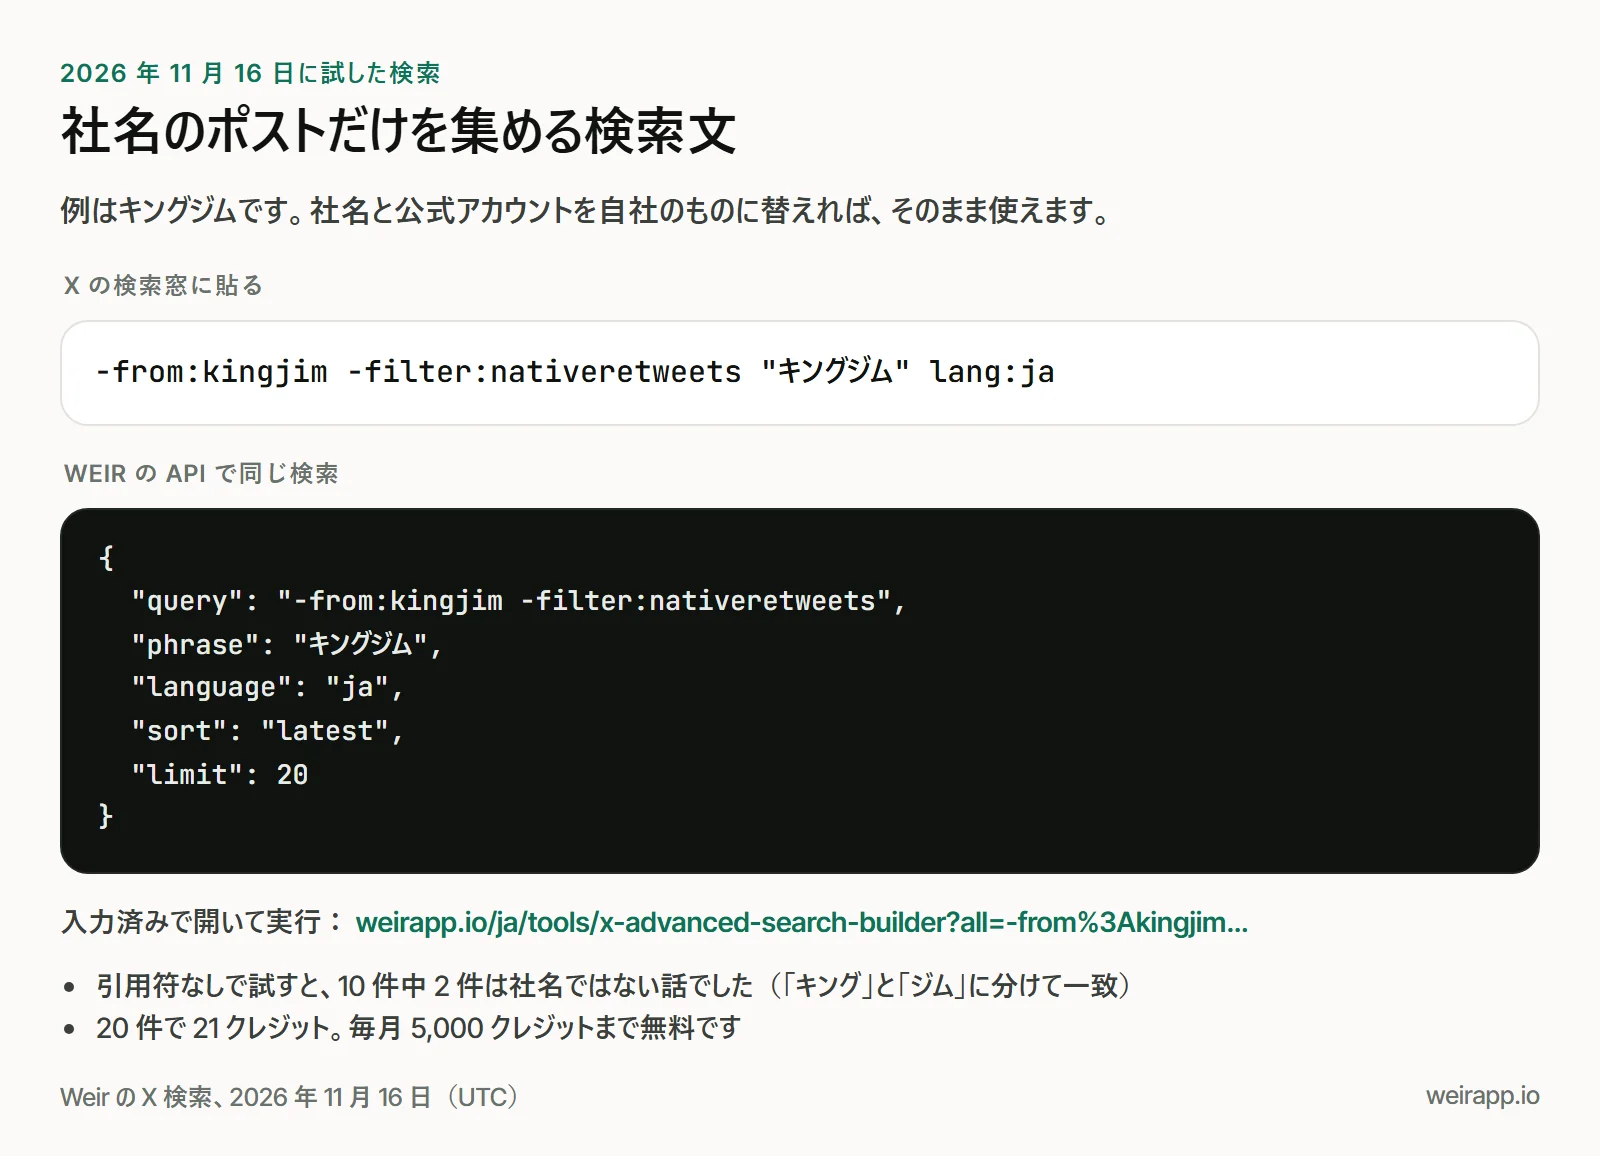
まず X の検索窓にこれを貼り、[最新]タブで見ます。社名と公式アカウントは、自社のものに替えます。
-from:kingjim -filter:nativeretweets "キングジム" lang:ja- 検索文を決める社名を引用符で囲みます。
- X で中身を見る[最新]タブで確かめます。
- 方法を選ぶCSV、AI アプリ、自動から。
- 新着だけを足す前回の続きから集めます。
X のポストを収集する 3 つの方法:どれが合う?
手間と頻度で選びます(2026 年 11 月 16 日時点)。
| 方法 | 向く人 | 集まり方 | 費用(クレジット) |
|---|---|---|---|
| ビルダーの CSV | コードを書かない人 | 押すたびに 20 件 | 1 回 21 |
| AI アプリ + Weir | Claude や ChatGPT の利用者 | 週 1 回のまとめ | 20 件ごとに 21 |
| モニターか Python | 毎日ほしい人 | 毎日、新着だけ | 1 回 1、新着 1 件 1 |
X のポストを集める検索文:4 つのレシピ
4 つとも X 高度な検索ビルダーで作り、11 月 16 日に試しました。「入力済みで開く」なら、X のアカウントなしで最初の 20 件を見て CSV にできます。
1. ブランド名は引用符で囲む
冒頭の検索文です。引用符なしでは、10 件中 2 件がポケモンの話でした。X が「キングジム」を「キング」と「ジム」に分けて照合したためです。
引用符で囲むと 10 件すべてに社名が入り、専門誌、文具店、株価、求人、愛用者の声が混ざりました。入力済みで開く
2. キャンペーンのハッシュタグ
キングジムは 11 月 25 日まで、「スキットマン」1,000 万冊突破のプレゼントを開いています。応募はフォローとリポストで、「スキットマン」と返信すると当選率が上がります。
-filter:nativeretweets #スキットマン lang:ja10 件中 9 件がハッシュタグ付きの返信だったので、返信は除きません。ハッシュタグのない返信と、リポストだけの応募は入りません。入力済みで開く
3. 商品名(カテゴリも同じ形)
-filter:nativeretweets "ポメラ" lang:ja -filter:replies次の章で 1 週間集めた検索文です。返信を含めると 20 件中 8 件が返信だったので、除きました。入力済みで開く
4. 公式アカウントの投稿
-filter:nativeretweets from:kingjim -filter:replies自社や競合の告知だけが残ります。@kingjim の新しい 10 件は 12〜16 日の分で、7 件に画像がありました。入力済みで開く
目的別のほかの検索は、X 検索の便利レシピ にあります。
1 週間で何件集まる?ポメラで試した結果
検索 3 を 9 日 0 時(UTC)から集めると、81 のアカウントから 102 件、7 回の呼び出しで 109 クレジットでした。
いちばん多い 11 日の 19 件のうち、5 件は 1 人の連続投稿でした。
日本時間の夜 8〜11 時に、102 件中 27 件が集まっています。
驚いたのは、機械のポメラと言えないものが 12 件あったことです。犬の愛称、ユーザー名、ゲームの名前などでした。
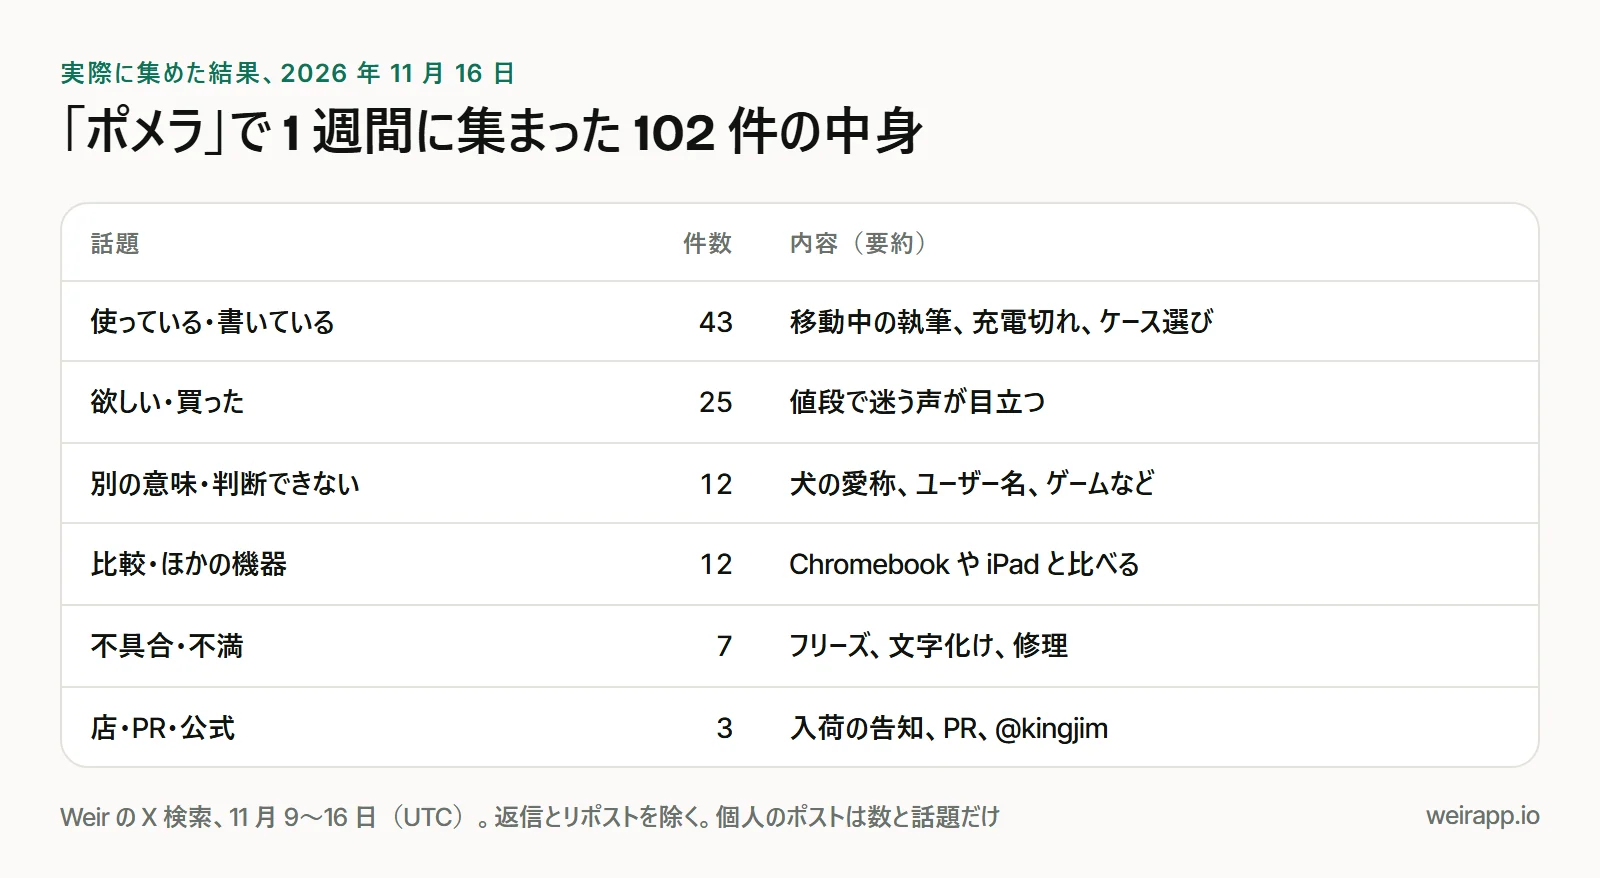
値段が高いという声は、話題をまたいで 7 件ありました。好意的か批判的かは、X の感情分析の手順で分けられます。
方法 1:コードなしで X のポストを CSV にする
ビルダーで[この検索を実行]を押すと、最初の 20 件が出ます。[CSV をダウンロード]で、id、日時、ユーザー名、本文、反応の数、URL の表になります。
このファイルは BOM 付きの UTF-8 なので、Excel でもそのまま開けます。文字化けしたら、[データ]→[テキスト/CSV から]で読み込みます。手順は ツイートをエクセルに出力する方法 にあります。
アカウントの投稿や 1 つのポストへの返信なら、ブラウザ拡張の Weir X Exporter(英語)でも CSV にできます。インストールのリンクは、各ストアの審査が通りしだい出ます。
方法 2:AI アプリに週 1 回まとめてもらう
Claude や ChatGPT に Weir をつないでいるなら、これを週に 1 回貼ります。つなぎ方は Claude と ChatGPT で X を検索する方法 にあります。
Weir の search_x で "ポメラ" -filter:nativeretweets -filter:replies lang:ja を 11 月 9 日から検索して。nextCursor がなくなるまでページを送り、日ごとの件数と話題ごとの件数を表にして。個人の投稿は引用しないで。11 月 16 日に同じ検索を MCP で実行して数えた答えが、前の章の表です。
方法 3:毎日自動で X のポストを収集する
Weir のモニターに任せる
モニターは検索を毎日か毎週実行し、新しいポストだけを Slack や Discord に送ります。
- 無料枠はモニター 1 本です。 毎時の実行は $5 のパックの後です。
- 1 回に読むのは約 20 件です。 ポメラは多い日でも 19 件でした。
- 重複は送りません。 内容のハッシュで新着を判定します。
作り方は X のキーワード通知の設定方法 にまとめました。
15 行の Python で CSV に追記する
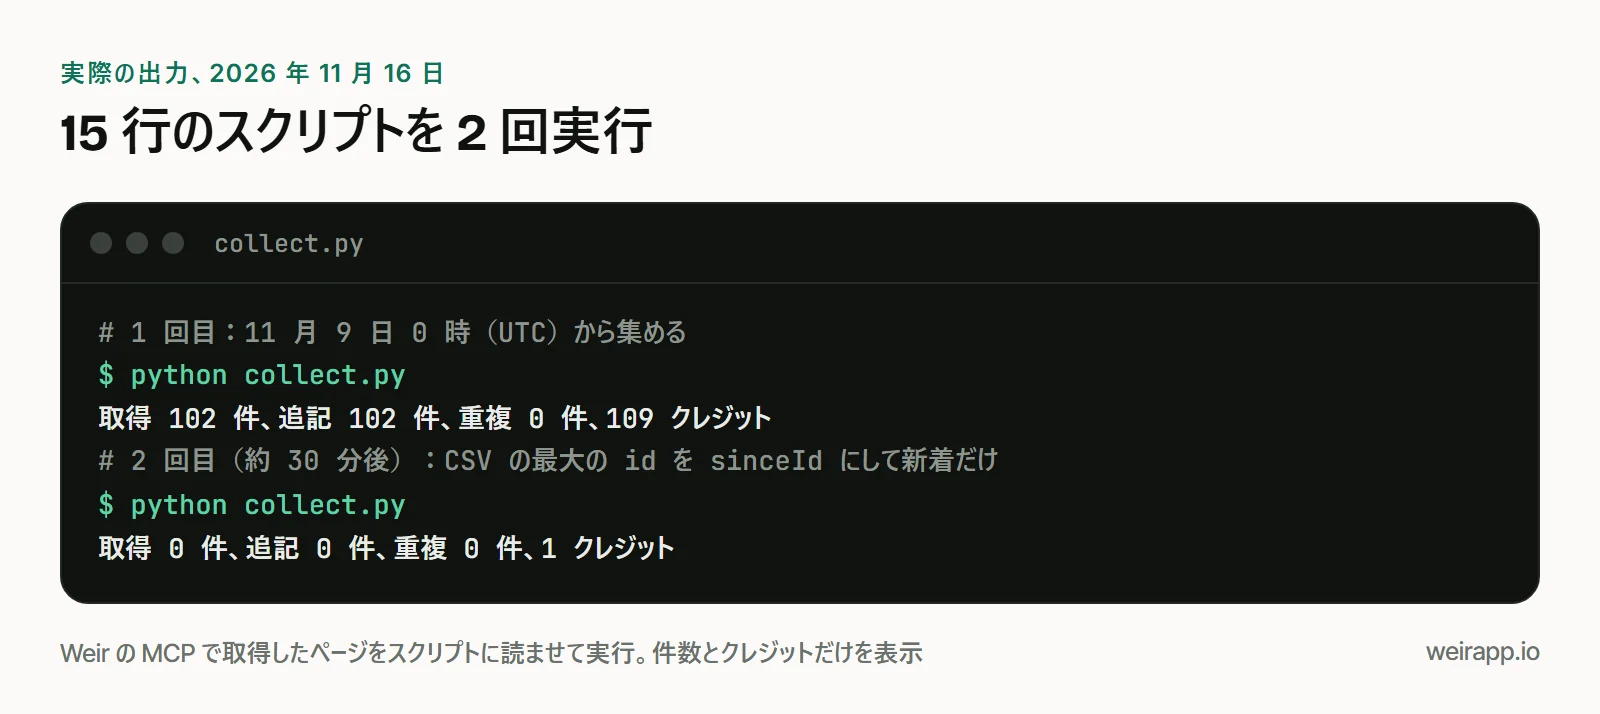
初回は since の日時から、2 回目からは CSV の最大の id を sinceId に入れて新着だけを集めます。標準ライブラリだけです。
import csv, json, os, urllib.request
FILE, posts, credits = "pomera.csv", [], 0  # 列:id、日時(UTC)、URL、本文
seen = {r[0] for r in csv.reader(open(FILE, encoding="utf-8-sig"))} if os.path.exists(FILE) else set()
body = {"query": "\"ポメラ\" -filter:nativeretweets -filter:replies lang:ja", "since": "2026-11-09T00:00:00Z"}
if seen: body["sinceId"] = max(seen, key=int)  # 2 回目からは、前回の最新より後だけ
head = {"Authorization": "Bearer " + os.environ["WEIR_API_KEY"], "Content-Type": "application/json"}
for _ in range(10):  # ページ数の上限
    req = urllib.request.Request("https://api.weirapp.io/v1/x/search", json.dumps(body).encode(), head)
    with urllib.request.urlopen(req, timeout=60) as r:
        page, credits = json.load(r), credits + int(r.headers["x-credits-charged"])
    posts, body["cursor"] = posts + page["data"], page["meta"]["nextCursor"]
    if not body["cursor"]: break
new = {p["id"]: [p["id"], p["createdAt"], p["url"], p["text"]] for p in posts if p["id"] not in seen}
csv.writer(open(FILE, "a", newline="", encoding="utf-8-sig")).writerows(new.values())
print(f"取得 {len(posts)} 件、追記 {len(new)} 件、重複 {len(posts) - len(new)} 件、{credits} クレジット")
11 月 16 日に同じ検索を Weir の MCP サーバーで実行し、返ったページをこのスクリプトに読ませました。2 回目は約 30 分後で、新着がなく 1 クレジットでした。
- 止める合図は
nextCursorの null だけです。 6 ページ目は 2 件でも続き、7 ページ目が空でした。 - [最新]も厳密な時刻順ではありません。 4 ページ目の先頭に、15 日のポストが 3 件ありました。
- 429 で止まったら、時間をおいて再実行します。 書き込みは最後なので、二重には入りません。
毎日動かすなら、cron か Windows のタスク スケジューラに登録します。基本は Python でツイートを取得する方法 にあります。
20 件のページは 21 クレジットです。毎月 5,000 クレジットまで無料で、$5(米ドル)で 25,000 クレジットを買えます。
Weir が向かないケース
- 鍵アカウントも要る:X のヘルプセンターによると、非公開のポストを検索できるのは本人とフォロワーだけです。
- 1 アカウントを表に送るだけ:Yoom などの連携ツールに、毎日スプレッドシートに記録するテンプレートがあります。
- X との契約が要る:Weir は X の公認ではなく、使える範囲が変わることがあります。
- 漏れのない全件が要る:Weir は X の検索を読むので、検索に出ないポストは集まりません。
Weir は公開データを読むだけです。X の規約が自分の使い方に当てはまるかは、各自で確かめてください。
よくある質問
X のポストを自動で収集できますか?
できます。検索文を 1 つ決め、Weir のモニターか 15 行の Python で毎日実行し、新しいポストだけを足します。
X の情報収集やデータ収集を無料でするには?
X の検索とリストは、アカウントがあれば無料です。ファイルに残すなら、Weir の毎月 5,000 クレジットで 20 件のページを約 238 回読めます。
集めたポストをエクセルで開くには?
スクリプトの CSV は BOM 付きなので、そのまま開けます。上書き保存すると 19 桁の id が丸められるので、コピーを開きます。
X のポストを自動で集めるのは規約違反ですか?
法的な助言はできません。X の自動化ルールは、ウェブサイトをスクリプトで操作する自動化を禁じ、永久凍結もありうるとしています。Weir はあなたの X アカウントを使いません。
参考資料
2026 年 11 月 16 日に確認しました(X のヘルプセンターは Wayback の版)。
- X Help Center, Automation rules(英語、11 月 1 日の版):https://web.archive.org/web/20261101183713/https://help.x.com/en/rules-and-policies/x-automation
- X Help Center, About public and protected posts(英語、9 月 19 日の版):https://web.archive.org/web/20260919080605/https://help.x.com/en/safety-and-security/public-and-protected-posts
- Microsoft サポート(CSV UTF-8、15 桁の精度は英語):https://support.microsoft.com/ja-jp/office/excel-で-csv-utf-8-ファイルを正しく開く方法-8a935af5-3416-4edd-ba7e-3dfd2bc4a032 、https://support.microsoft.com/en-us/office/keeping-leading-zeros-and-large-numbers-1bf7b935-36e1-4985-842f-5dfa51f85fe7
- Yoom のブログ(2026 年 10 月 7 日):https://lp.yoom.fun/blog-posts/how-to-automatically-collect-and-record-posts-from-specific-x-oauth-accounts
- キングジムのキャンペーンのポスト(11 月 12 日):https://x.com/kingjim/status/2120713200404660612
- Weir のドキュメント(英語):https://docs.weirapp.io/monitors 、https://docs.weirapp.io/billing 、https://docs.weirapp.io/pagination
- Weir の X 検索の実測(11 月 16 日、14 回で 177 クレジット)